
Llm_infer#
从零实现 DeepSeek-V2-Lite 推理:C++ 写算子,Python 整合成模型和推理引擎,用来研究 MLA(Multi-head Latent Attention)和 DeepSeekMoE。
- 算子通过
TORCH_LIBRARY注册为torch.ops.llm_infer.*,直接吃 torch 张量,没有拷贝。 - 每个 C++ 算子都有一份纯 PyTorch 参考实现(
llm_infer/ref_ops.py),用于单测对照和缺内核时回退。 - 整个模型和 transformers 原生
DeepseekV2ForCausalLM逐 logits 对齐(prefill、分页 decode、贪心生成)。
GPU 上的验证清单#
租到机器后按这个顺序走,前 6 步不需要下载模型权重,几分钟就能确认 CUDA 内核是对的。
# 仓库是公开的话用 HTTPS(服务器上没有你的 SSH key)
git clone https://github.com/clveryang/Llm_infer.git && cd Llm_infer

SKIP_MODEL=1 bash scripts/setup_vast.sh     # 检查环境 → 编译 → 测试 → 跑分,不下 32GB 权重
bash scripts/setup_vast.sh                  # 确认没问题后再下载模型做真实权重对比
脚本分 7 步,任何一步失败都会立刻停下并说明原因:
| 步骤 | 做什么 | 失败常见原因 |
|---|---|---|
| 1 | 查 GPU、驱动、nvcc | 用了 runtime 镜像(没有 nvcc),需要换 devel 镜像 |
| 2 | 查 torch 是否支持这张卡的架构 | Blackwell 需要 sm_120,脚本会自动装 cu128 版 |
| 3 | 装依赖 | — |
| 4 | 编译并确认 11 个 CUDA 内核都注册上了 | 显存/内存不够时调小 MAX_JOBS |
| 5 | 单元测试:算子对拍 + 小模型对比 transformers | 内核有 bug,看具体哪个算子 |
| 6 | 性能对比:自写内核 vs PyTorch | — |
| 7 | 下载权重,和 transformers 比 logits 和贪心生成 | 磁盘不足(要 ≥150GB) |
单独跑其中某一项:
pytest -q tests/test_ops.py -k cuda            # 只测 CUDA 算子
python scripts/bench.py                        # 算子性能
python scripts/bench.py --model-dir <dir> --e2e   # 端到端吞吐(两种后端对比)
python scripts/compare_hf.py --model-dir <dir>    # 真实权重对比 transformers
文档#
- 模型结构详解 — 从 embedding 到 logits 逐个部件讲清楚,适合先通读一遍
- 下面是速览和实现细节
DeepSeek-V2-Lite 结构速览#
官方架构图#
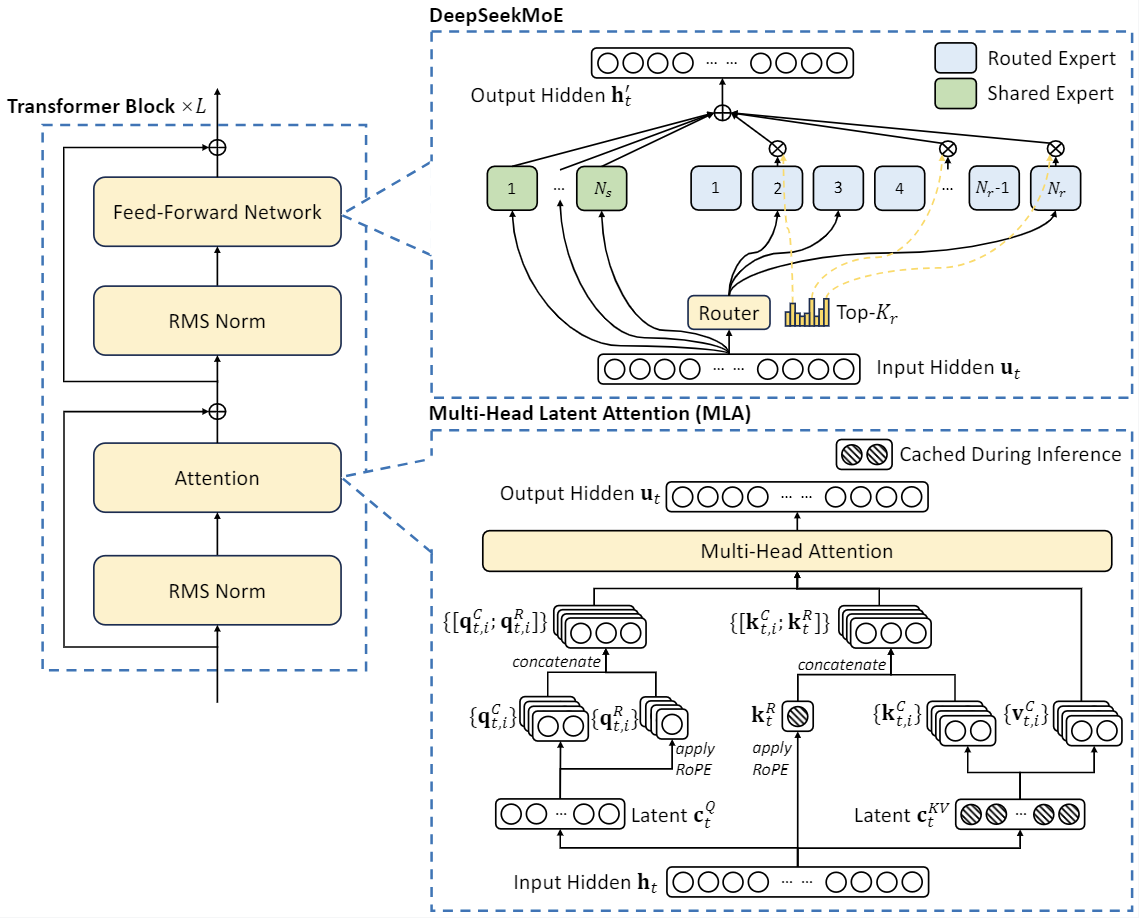
图源:deepseek-ai/DeepSeek-V2(MIT),论文 arXiv:2405.04434。
图中带斜线的圆圈是推理时缓存的内容:latent cKV 和 kR。
注意:图里 Q 也先压缩到 latent cQ,那是完整版 V2 的做法;V2-Lite 没有这一步(q_lora_rank=None),直接 q_proj 出 q。
关键参数#
| 项目 | 数值 |
|---|---|
| 总参数 / 激活参数 | 15.7B / 2.4B |
| 层数 | 27(第 0 层普通 FFN,1–26 层 MoE) |
| hidden / 头数 | 2048 / 16 |
| MLA | kv_lora_rank=512,q_lora_rank=None,QK = 128 (nope) + 64 (rope),V = 128 |
| MoE | 64 路由专家选 6 + 2 共享专家,专家中间层 1408,softmax + greedy top-k,不重新归一化 |
| RoPE | YaRN,factor 40,注意力 scale = mscale² / √192 ≈ 0.1147 |
| KV cache | 每 token 每层 576 维(512 latent + 64 k_pe),bf16 下每 token 共 30.4 KB |
整体结构#
flowchart LR
    ids["input_ids [N]"] --> emb["embed_tokens<br/>102400 × 2048"]
    emb --> L0["第 0 层<br/>MLA + dense FFN<br/>2048 → 10944 → 2048"]
    L0 --> L1["第 1–26 层(×26)<br/>MLA + DeepSeekMoE<br/>64 选 6 + 2 共享"]
    L1 --> fn["RMSNorm"] --> head["lm_head<br/>2048 → 102400"] --> logits["logits"]
每一层都是 pre-norm 残差结构:
flowchart LR
    x["hidden [N, 2048]"] --> n1["RMSNorm"] --> attn["MLA"] --> add1(("+"))
    x --> add1
    add1 --> n2["RMSNorm"] --> ffn["FFN 或 MoE"] --> add2(("+"))
    add1 --> add2
    add2 --> y["下一层"]
代码里把「+ 残差」和下一个 RMSNorm 合并成一个算子 fused_add_rms_norm,少读写一遍内存。
MLA(一层注意力)#
图中加粗的是本项目的 C++ 算子。权重形状和「为什么这么设计」见
模型结构详解 · MLA,
或直接跑 python scripts/mla_shapes.py 把每一步的形状打出来。
① 投影、RoPE、写 cache:prefill 和 decode 都一样
flowchart TB
    h["h [N, 2048]"]
    h --> qproj["q_proj<br/>2048 → 16 × 192"]
    h --> kva["kv_a_proj_with_mqa<br/>2048 → 576"]
    qproj --> qnope["q_nope [N, 16, 128]<br/>不带位置"]
    qproj --> qpe["q_pe [N, 16, 64]"]
    kva --> lat["latent [N, 512]"]
    kva --> kpe["k_pe [N, 1, 64]<br/>所有头共享一份"]
    lat --> kvnorm["kv_a_layernorm<br/><b>rms_norm</b>"]
    qpe --> rope["<b>rotary_embedding</b><br/>YaRN,交错排列"]
    kpe --> rope
    kvnorm --> cache[("<b>concat_and_cache_mla</b><br/>KV cache 每行 576 维<br/>= latent 512 + k_pe 64")]
    rope -- "k_pe" --> cache
    rope -- "q_pe" --> qout["q_pe(已旋转)"]
② 注意力:prefill 和 decode 走不同路径
flowchart LR
    subgraph prefill["prefill:解压后做标准注意力"]
        direction TB
        p_lat["latent [N, 512]"] --> kvb["kv_b_proj 512 → 16 × 256"]
        kvb --> p_split["k_nope [N,16,128]<br/>v [N,16,128]"]
        p_q["q_nope + q_pe"] --> p_cat["q, k 都是 192 维<br/>k_pe 复制到 16 个头"]
        p_split --> p_cat
        p_cat --> pattn["<b>mla_prefill_attention</b><br/>因果,scale ≈ 0.1147<br/>输出 [N,16,128]"]
    end
    subgraph decode["decode:不解压 cache"]
        direction TB
        d_q["q_nope [B,16,128]"] --> qlat["× W_kᵀ → [B,16,512]<br/>拼上 q_pe → [B,16,576]"]
        d_cache[("KV cache<br/>[blocks, 16, 576]")] --> dattn
        qlat --> dattn["<b>mla_decode_attention</b><br/>和 cache 行直接点积<br/>输出 latent 加权和 [B,16,512]"]
        dattn --> wv["× W_v → [B,16,128]"]
    end
    pattn --> oproj["o_proj<br/>16 × 128 → 2048"]
    wv --> oproj
decode 为什么可以不解压?kv_b_proj 的权重按行切成 W_k(前 128 行)和 W_v(后 128 行),利用两条恒等式
(tests/test_ops.py::test_latent_decode_equals_decompressed_attention 验证):
q_nope · (W_k c) = (W_kᵀ q_nope) · c          # 注意力分数:query 投影到 latent 空间,直接和 cache 点积
Σ aₜ (W_v cₜ)    = W_v (Σ aₜ cₜ)               # value:先在 latent 空间加权求和,最后乘一次 W_v
KV cache 有多省#
按 V2-Lite 的头维度(K 192、V 128),每个 token 每层需要缓存的元素数:
| 方案 | 每 token 每层 | 相对 MHA |
|---|---|---|
| MHA(16 头 × (192 + 128)) | 5120 | ████████████████████ 100% |
| GQA 4 组(假设同样头维度) | 1280 | █████ 25% |
| MLA(V2-Lite 实际) | 576 | ██▎ 11.3% |
| MQA 1 组(假设同样头维度) | 320 | █▎ 6.3% |
MLA 缓存量接近 MQA,但每个头仍然有自己的 k_nope 和 v(从 latent 解压得到),表达能力接近 MHA。
分页 KV cache 的组织#
kv_cache[layer] : [num_blocks, block_size=16, 576]
                                               └─ 每行 = [ latent 512 | k_pe 64 ]

seq A(37 个 token)block_table = [5, 2, 9]
  block 5 : token  0–15
  block 2 : token 16–31
  block 9 : token 32–36(剩 11 个空位留给后续 decode)

slot = block_id × 16 + offset      # concat_and_cache_mla 按 slot 写入
                                   # mla_decode_attention 按 block_table 读出
DeepSeekMoE(一层 FFN)#
flowchart LR
    x["x [N, 2048]"] --> gate["gate:Linear 2048 → 64<br/>float32"]
    gate --> topk["<b>topk_softmax</b><br/>softmax 后取 top-6<br/>weights [N,6],ids [N,6]"]
    topk -- "ids" --> align["<b>moe_align</b><br/>按专家计数排序<br/>sorted_idx [6N],offsets [65]"]
    x --> gather["index_select<br/>按专家排好的 token [6N, 2048]"]
    align --> gather
    gather --> expert["<b>moe_expert_forward</b><br/>每个专家一个 SwiGLU<br/>2048 → 1408 → 2048"]
    expert --> combine["<b>moe_combine</b><br/>乘路由权重,加回 token 顺序<br/>[N, 2048]"]
    topk -- "weights" --> combine
    align -- "sorted_idx" --> combine
    x --> shared["shared_experts<br/>2 个合成 1 个 SwiGLU<br/>2048 → 2816 → 2048"]
    combine --> add(("+"))
    shared --> add
    add --> out["out [N, 2048]"]
moe_align 的作用:把 N 个 token × 6 个选择按专家编号排好,每个专家的 token 挨在一起,
这样 moe_expert_forward 每个专家只做一次矩阵乘,而不是逐 token 计算。例如 N=3、top-2、4 个专家:
topk_ids  = [[2, 0],   [1, 2],   [0, 3]]       # 扁平下标 0..5
sorted_idx = [1, 4,  2,  0, 3,  5]              # 专家 0: 扁平位置 1,4;专家 1: 2;专家 2: 0,3;专家 3: 5
offsets    = [0, 2, 3, 5, 6]
token 号   = sorted_idx // 2 = [0, 2, 1, 0, 1, 2]
算子列表#
| 算子 | 用途 | CPU C++ | CUDA |
|---|---|---|---|
rms_norm |
各处 RMSNorm | ✅ | 🟡 |
fused_add_rms_norm |
残差相加 + RMSNorm 融合 | ✅ | 🟡 |
silu_and_mul |
SwiGLU 激活 | ✅ | 🟡 |
rotary_embedding |
YaRN RoPE(交错 / neox 两种排列) | ✅ | 🟡 |
concat_and_cache_mla |
写分页 latent KV cache | ✅ | 🟡 |
mla_prefill_attention |
变长因果注意力,QK/V 维度不同 | ✅ | 🟡 |
mla_decode_attention |
在压缩 cache 上的分页 decode 注意力 | ✅ | 🟡 |
topk_softmax |
MoE 路由 | ✅ | 🟡 |
moe_align |
按专家计数排序 | ✅ | 🟡 |
moe_expert_forward |
分组 SwiGLU 专家计算 | ✅ | 🟡 |
moe_combine |
加权合并回 token 顺序 | ✅ | 🟡 |
✅ 已实现并通过测试 🟡 已实现,用 CUDA 12.8 nvcc 针对 sm_120(Blackwell)编译通过(Docker 内无 GPU,只做了编译检查),还没在真实 GPU 上跑过测试
Embedding、Linear、lm_head 直接用 torch(BLAS / cuBLAS)。
- CPU 内核支持 float32 / float64(CPU 上 bf16 没有原生算术类型,其他 dtype 自动回退到
ref_ops)。 - CUDA 内核支持 float32 / float16 / bfloat16 / float64,半精度在内核里提升到 float32 计算再写回。
- CUDA 版本是朴素实现,重在对照理解:注意力每个 (query, head) 一个 GPU 线程、两遍扫描完成 softmax(第一遍 double 累加 logsumexp,第二遍加权求和,不占额外显存); 专家计算每个专家两次 cuBLAS 矩阵乘。性能优化方向见文末。
目录#
csrc/
  ops.h                  算子声明和语义说明
  torch_bindings.cpp     schema 定义(TORCH_LIBRARY)
  cpu/norm_act.cpp       rms_norm / fused_add_rms_norm / silu_and_mul
  cpu/mla.cpp            rotary / cache 写入 / prefill & decode 注意力
  cpu/moe.cpp            topk_softmax / moe_align / expert_forward / combine
  cuda/common.cuh        dtype 分发宏、launch 辅助、logsumexp
  cuda/norm_act.cu       rms_norm / fused_add_rms_norm / silu_and_mul
  cuda/mla.cu            rotary / cache 写入 / prefill & decode 注意力
  cuda/moe.cu            topk_softmax / moe_align / expert_forward / combine
llm_infer/
  ops.py                 分发层:C++ 内核 or 参考实现
  ref_ops.py             纯 PyTorch 参考实现
  config.py              配置(兼容 Hub config.json 和 transformers 格式)
  rope.py                YaRN cos/sin 表、注意力 scale
  model.py               MLA / MoE / 解码层 / 整个模型
  engine.py              分页 KV cache + prefill/decode + 采样
  loader.py              safetensors 加载(专家权重直接拷入堆叠张量)
tests/
  test_ops.py            每个 C++ 算子 vs 参考实现
  test_model_vs_hf.py    小号随机模型 vs transformers,含 Hub 格式加载
scripts/
  setup_vast.sh          vast.ai 一键环境 + 下载模型 + 对比
  compare_hf.py          真实权重下和 transformers 对比
examples/generate.py     命令行生成
本地(Mac / Linux CPU)#
uv venv --python 3.12 .venv && source .venv/bin/activate
uv pip install torch transformers safetensors pytest ninja setuptools
pip install -e . --no-build-isolation      # 或 python setup.py build_ext --inplace
pytest -q tests                            # 29 个测试
后端切换:LLM_INFER_BACKEND=auto|cpp|torch,或代码里 llm_infer.ops.set_backend(...)。
GPU(vast.ai,RTX PRO 6000 Blackwell 96GB)#
镜像选 pytorch/pytorch:*-cuda12.8-cudnn9-devel 或更新的 devel 版,磁盘 ≥150GB。
git clone https://github.com/clveryang/Llm_infer.git && cd Llm_infer
SKIP_MODEL=1 bash scripts/setup_vast.sh     # 先验证内核(不下载权重)
bash scripts/setup_vast.sh                  # 再跑完整流程
python examples/generate.py --model-dir checkpoints/DeepSeek-V2-Lite-Chat --prompt "介绍一下 MLA"
详见上面的 GPU 上的验证清单。
Blackwell 注意:torch 需要支持 sm_120(CUDA ≥ 12.8、驱动 ≥ 570),编译扩展时设置 TORCH_CUDA_ARCH_LIST=12.0。
下一步:在 GPU 上验证和优化 CUDA 内核#
bash scripts/setup_vast.sh                    # 编译 + 全部测试 + 下载模型 + 和 transformers 对比
pytest -q tests/test_ops.py -k cuda           # 只跑 CUDA 算子测试
LLM_INFER_BACKEND=torch python examples/generate.py ...   # 对照:全部走 PyTorch 参考实现
tests/test_ops.py 在有 GPU 时自动加入 cuda 设备:fp32/fp64 和参考实现逐元素对比,fp16/bf16 和「转 float32 后的参考实现」对比;
tests/test_model_vs_hf.py 会把小模型放到 GPU 上和 transformers 对比 logits。
性能优化方向(从收益大到小):
1. mla_decode_attention:按 block 分块、多个 key 并行算点积,参考 FlashMLA / FlashInfer 的 MLA decode kernel
2. moe_expert_forward:grouped GEMM(cublasGemmGroupedBatchedEx 或 Triton),去掉逐专家循环和 offsets 的 CPU 同步
3. mla_prefill_attention:分块 tiled attention(FlashAttention 思路),或直接调用 FlashAttention 做 V pad
4. moe_align:并行版本(参考 vLLM moe_align_block_size)
5. CUDA Graph 捕获 decode 步,去掉 Python / launch 开销